Një arkitekturë e re e inteligjencës artificiale që mëson nga pak shembuj
Autorët: Oriod Malo, Alexandre Xavier Falcão dhe Laurent Najman — IEEE Access
A mund të mësojë një sistem i inteligjencës artificiale të dallojë objekte të reja pasi ka parë vetëm një ose pesë shembuj? Për njerëzit, kjo shpesh është diçka e natyrshme. Për rrjetet neurale, që zakonisht trajnohen me mijëra imazhe, është një sfidë krejt tjetër.
Kjo sfidë njihet si mësimi me pak shembuj (Few-Shot Learning, FSL). Ajo bëhet veçanërisht e rëndësishme në mjekësi, ku imazhet e etiketuara mund të jenë të pakta, të kushtueshme për t’u përgatitur ose të vështira për t’u siguruar. Në vend që të kërkojmë gjithmonë më shumë të dhëna, mund të pyesim: a mund ta përmirësojmë vetë mënyrën se si rrjeti i sheh imazhet?
Pikërisht kësaj pyetjeje i përgjigjet punimi ynë “A Novel Lightweight Multi-Scale Branching Encoder for Few-Shot Image Classification”, i pranuar për botim në revistën ndërkombëtare IEEE Access. Ai propozon Sum12, një arkitekturë të re konvolucionale që mëson tipare vizuale në disa shkallë, pa u mbështetur në një model tepër të rëndë.
Si funksionon?
Imagjinoni se po analizoni një fotografi: një hollësi e vogël mund të jetë vendimtare, por kuptimi i saj varet edhe nga struktura më e gjerë përreth. Rrjetet tradicionale konvolucionale nuk i kombinojnë gjithmonë këto nivele informacioni në mënyrë të drejtpërdrejtë.
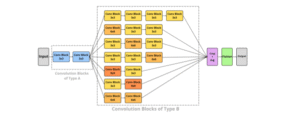
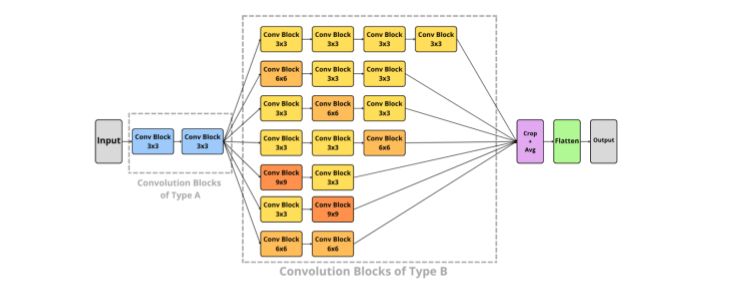
Sum12 përdor shtatë degë konvolucionale paralele. Çdo degë përpunon të njëjtin informacion përmes një sekuence të ndryshme filtrash me përmasa 3×3, 6×6 ose 9×9. Rregulli që bashkon të gjitha degët është i thjeshtë: shuma e madhësive të filtrave në secilën sekuencë është 12. Kështu, rrjeti analizon struktura të madhësive të ndryshme dhe ruan një organizim kompakt.
Pse ka rëndësi?
Shpesh, përmirësimi i saktësisë arrihet duke ndërtuar modele gjithnjë e më të mëdha. Sum12 ndjek një rrugë tjetër: shtatë degë paralele për të kombinuar tipare në shkallë të ndryshme. Arkitektura u testua në 16 baza të dhënash: Omniglot, CIFAR-FS, FC100 e miniImageNet për Few-Shot Learning, si dhe 12 koleksione MedMNIST 2D. Krahasimi me Prototypical Networks u bë nën të njëjtat kushte ekSperimentale. Ja disa prej rezultateve: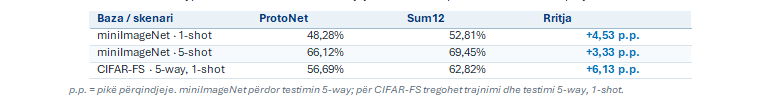
Po në imazherinë mjekësore?
Në 12 koleksionet MedMNIST 2D, me imazhe nga modalitete të ndryshme, Sum12 u vlerësua edhe në klasifikim të mbikëqyrur (jo Few-Shot). Në rezolucionin 224×224 arriti saktësi mesatare 83,4% dhe AUC 91,9%. Google AutoML Vision arriti AUC 92,7%, por saktësi mesatare 80,9%. Sum12 u rendit e para për saktësi në katër prej 12 bazave të të dhënave.
Kjo e bën arkitekturën interesante për kërkime në imazherinë mjekësore, por jo ende të validuar për vendimmarrje klinike. Studimi evidentoi ndryshueshmëri të rezultateve në grupe shumë të vogla dhe të çekuilibruara, si BreastMNIST.
Një hap drejt pajisjeve me burime të kufizuara
Enkoduesi standard ka rreth 1,88 milionë parametra; varianti me konvolucione të dilatuara rreth 0,74 milionë. Pas kuantizimit INT8, modeli u zvogëlua në rreth 799 KB dhe u vendos në mikrokontrolluesin STM32 NUCLEO-H753ZI. Mospërputhjet mes rezultateve në kompjuter dhe atyre në mikrokontrollues tregojnë se ky implementim nuk është ende i validuar funksionalisht për klasifikimin Few-Shot. Zgjidhja e tyre është një drejtim i punës së ardhshme.Ku mund të zbatohet?
- Në njohjen vizuale me pak imazhe të etiketuara për klasë.
- Në analizën e imazheve mjekësore me të dhëna të pakta.
- Në projektimin e modeleve kompakte për pajisje me burime të kufizuara.
Ky punim bashkon studiues nga Universiteti Metropolitan Tirana, University of Campinas, Khalifa University dhe Université Gustave Eiffel / CNRS.
Publikimi: Malo, O., Falcão, A. X., & Najman, L. “A Novel Lightweight Multi-Scale Branching Encoder for Few-Shot Image Classification.” IEEE Access (versioni i pranuar). DOI: https://doi.org/10.1109/ACCESS.2026.3745693